Agent 与记忆系统:从基础到进阶的全面教程
导语
在复杂 AI 应用中,Agent 如同“大脑”,而记忆系统则是支撑其决策的“知识库”。无论是处理多轮对话、复杂任务规划,还是自主调用工具,Agent 都需要清晰的记忆管理和逻辑推理能力。本文将系统拆解 Agent 与记忆系统的核心技术:从短期/长期记忆的设计,到意图识别、规划能力,再到不同框架(LangChain/LangGraph)的选型与工程落地,帮助你构建完整的 Agent 系统知识体系。
1. 长期记忆 vs 短期记忆:构建“活的上下文”
1.1 短期记忆:应对即时对话的“窗口缓存”
是什么?
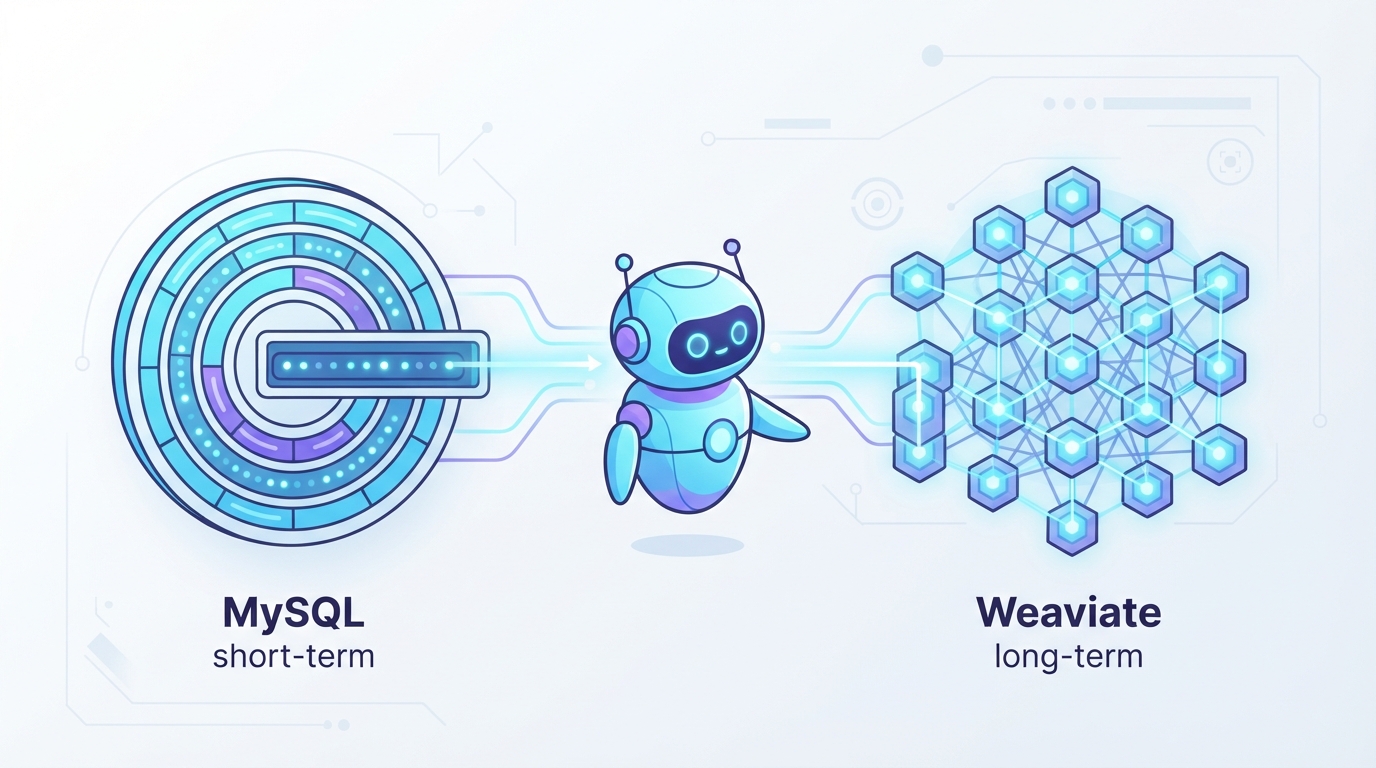
短期记忆用于存储最近的对话片段,避免上下文信息因历史过长而“爆炸”。我们采用 MySQL 会话表+消息表 实现,核心是 滑动窗口机制:只保留最近 5 轮对话,并通过 AI 对这 5 轮内容生成摘要,将原始信息压缩为“关键信息包”。
为什么这样设计?
- 模型的 Token 数量有限(如单次请求约 4k Token),若直接存储全量历史,会因“信息过载”导致关键内容被稀释(即“中间遗忘”)。
- 滑动窗口仅保留最近 5 轮,每 5 轮生成摘要,既能减少 Token 消耗,又能确保核心对话不丢失。
如何实现?
- 对话发生时,实时将消息存入会话表,同时维护“轮次计数器”,当达到 5 轮时,触发摘要生成逻辑(调用 LLM 对这 5 轮内容进行关键信息提取)。
- 后续对话中,用“最近 5 轮原始消息+最新摘要”作为上下文,避免全历史污染。
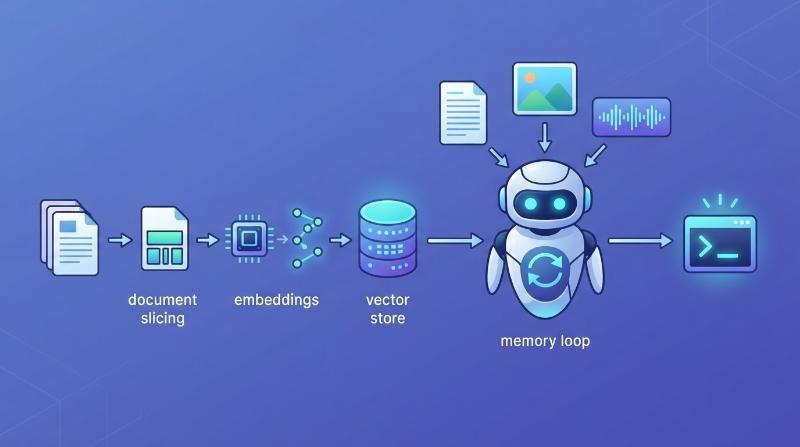
1.2 长期记忆:向量化存储的“深层知识库”
是什么?
长期记忆采用 Weaviate 向量数据库 存储,将文本转化为向量,便于语义检索。按 6 种类型分类管理,每种类型有独立的 重要性阈值 和 保留天数:
| 类型 | 重要性阈值 | 保留天数 | 典型场景 |
|---|---|---|---|
| person(人物) | 0.8 | 365 | 存储用户身份、历史互动关系 |
| place(地点) | 0.7 | 180 | 地理位置、场景信息 |
| preference(偏好) | 0.9 | 730 | 用户兴趣、习惯(如喜欢的饮品) |
| commitment(承诺) | 0.9 | 365 | 用户明确的目标或约定(如“明天交报告”) |
| learning(学习) | 0.8 | 1095 | 知识积累、技能学习记录 |
| fact(事实) | 0.6 | 90 | 时效性强的信息(如新闻、公式) |
为什么这样分类?
不同类型的信息对“重要性”和“时效性”需求不同:
- 偏好和承诺(重要性阈值 0.9)需长期保留(730 天/365 天),如用户“喜欢周杰伦”的偏好可能持续数年;
- 事实(重要性阈值 0.6)时效性强(90 天),如“今天气温 25℃”需及时更新。
管理策略与生命周期
长期记忆的生命周期分为 6 个阶段:
- 创建:模型输出内容后,评估是否为“关键信息”(结合重要性阈值);
- 评估:对新信息标记“重要性分数”和“时间戳”,高分数信息优先保留;
- 迁移:短期记忆摘要达到 10 条后,将高价值摘要迁移至长期记忆;
- 压缩:定期对相似记忆(如重复的“学习记录”)进行聚类,生成“记忆摘要”;
- 归档:过期信息(如超过保留天数)移至归档库,仅保留元数据;
- 删除:归档后数据经审计无价值则永久删除。
冲突处理:为什么不物理覆盖?
当新信息与旧信息冲突(如“今天想喝奶茶” vs “昨天想喝可乐”),我们不直接覆盖旧记录,而是通过 时间衰减系数 标记旧信息为“低权重”,新信息为“高权重”。检索时,系统优先返回最近且高权重的记忆,确保历史轨迹完整(便于分析用户偏好变化)。
1.3 为什么向量库+摘要而非 MySQL 直接筛选历史?
你可能会问:“用 MySQL 存储历史,通过 LIKE 或 Text-to-SQL 筛选不也可以吗?”
① 语义理解 vs 文本匹配:
自然语言中存在大量模糊表达(如“前天那道几何题”),MySQL 只能通过精确关键词匹配,容错率低;而向量库通过语义检索(如计算余弦相似度),能理解“几何题”的上下文,返回更相关的历史。
② 信息提纯 vs 原始存储:
若直接存储全量历史,Token 会因“中间遗忘”失效(如用户聊到第 20 轮时,前 10 轮内容已模糊);摘要生成相当于“信息提纯”,保留核心细节(如“几何题+解题思路”),避免 Token 浪费。
2. 意图识别与路由:给 Agent “指路”的总控中心
当用户输入问题时,首页总控 Agent 的核心任务是 意图识别与路由——将用户需求分类为预设场景,并分发至对应模块。
2.1 路由逻辑
- 预设意图匹配:通过轻量提示词(如
请将输入分类为:拍照搜题/写作辅导/判题/闲聊),快速将用户输入映射到固定意图; - 统一返回路由 Schema:匹配成功后,返回结构化路由信息(如
{"action": "jump_to", "page": "math_solver"}),前端根据此 Schema 跳转页面; - 兜底策略:若未匹配到预设意图,调用大模型进行自由对话(如“我不太理解你的需求,可以补充说明吗?”);
- 安全护栏:对越界输入(如违法内容),通过 Guardrails 拦截,强化角色边界(如“我只能回答与学习相关的问题”)。
2.2 路由的本质:明确“谁做什么”
总控 Agent 如同“交通枢纽”,通过分类路由避免“大模型盲目生成”,确保每个任务有专门的子模块处理(如“拍照搜题”调用图像识别+解题模型,“判题”调用代码校验工具)。
3. Agent 规划能力:从“直觉生成”到“逻辑搜索”
Agent 的核心价值在于规划——将大模型的“直觉式回答”转化为“可执行的逻辑路径”。不同任务复杂度对应不同规划策略:
3.1 基础任务:ReAct(边做边想)
- 流程:
Thought → Action → Observation → 下一轮 Thought:模型思考“下一步做什么”(如“需要调用计算器”);Action:执行工具调用(如call_calculator(2+3));Observation:工具返回结果(如“5”);- 循环:重复上述步骤直到任务完成。
- 优点:实时纠错,适合短链任务(如“计算 100×1.2”);
- 缺点:易死循环(如重复调用同一工具)、Token 消耗大(每轮携带全历史)。
3.2 复杂决策:ToT/GoT(思维树/图)
- ToT(思维树):每步生成多个候选分支(如“解题方法 A/B/C”),通过回溯剪枝选最优路径(适合多解法问题,如“数学证明题”);
- GoT(思维图):节点间任意连接,可合并不同路径的结论(比树更灵活,适合跨领域问题,如“旅行规划:订机票+酒店+景点”)。
3.3 工业级稳定:Plan-and-Execute + Self-Reflection
- Plan-and-Execute:先拆解任务为“清晰步骤”(如“1. 查天气 2. 订酒店 3. 安排行程”),再严格执行;
- 优势:逻辑清晰,适合长链条任务(如“写一篇产品分析报告”);
- Self-Reflection:执行后进行自我批判(如“计划是否遗漏预算?”),迭代优化输出。
4. 规划范式进阶:CoT、ToT、反思(Reflexion)
4.1 主流规划方法对比
| 方法 | 核心逻辑 | 典型场景 |
|---|---|---|
| CoT(思维链) | 让模型“显式写出推理过程”(线性单链) | 简单数学推理(如“2+3=5”) |
| ToT(思维树) | 多分支搜索,可回溯剪枝 | 复杂决策(如“选旅游目的地”) |
| GoT(思维图) | 节点间任意连接,合并中间结论 | 跨领域问题(如“项目管理”) |
| Plan-and-Solve | 预定义步骤,严格执行 | 确定性任务(如“数据统计”) |
| Reflexion(反思) | 执行→反思→优化,迭代改进输出 | 需长期优化的目标(如“学习计划”) |
CoT vs Planning 的本质区别:
- CoT 是“把思考过程写出来”(不可执行,仅辅助模型理解);
- Planning 是“生成可执行的任务序列”(如“①调工具查天气 ②订酒店”),每步可独立验证。
5. 多 Agent 动态路由:让任务“分而治之”
多 Agent 协作的核心是 动态路由——总控 Agent 根据意图或上下文条件,将任务分发到不同子 Agent。
5.1 实现方式
- LangGraph 条件边:通过
conditional edge定义路由规则(如“若问题含‘数学题’则调 math_solver_Agent”); - 路由函数输出:让 LLM 直接输出结构化决策(如
{"agent": "math_solver", "params": {"question_id": 123}}); - 分支执行与汇聚:子 Agent 执行完成后,将结果回传给主流程,实现闭环。
5.2 与意图识别的关系
意图识别是“分类用户输入”,动态路由是“分配任务到子 Agent”,两者本质是同一件事的不同粒度(前者是“大方向”,后者是“具体执行者”)。
6. LangChain vs LangGraph:不同场景的框架选型
6.1 核心差异
| 特性 | LangChain(LCEL) | LangGraph |
|---|---|---|
| 架构 | 线性流水线(DAG 有向无环) | 复杂网络地图(Graph 有向有环) |
| 状态管理 | 单向数据流,难持久化 | 内置状态机,支持持久化/回溯 |
| 循环控制 | 极难实现循环 | 天然支持循环和分支(如重试) |
| 场景 | 基础 RAG、单向 Agent | 多 Agent 协同、人机交互循环 |
LangGraph 三大优势:
- 持久执行:故障中断后可从断点恢复(如“订酒店失败,从‘选日期’重新开始”);
- 人机协同:执行中可暂停,人工修改状态(如“用户说‘换个酒店’,系统更新酒店列表”);
- 全面记忆:短期工作记忆+跨会话长期记忆(支持历史轨迹分析)。
7. 记忆冲突与更新:让“历史”服务于“现在”
7.1 冲突处理原则
- 偏好类冲突:如“喜欢咖啡” vs “喜欢茶”,不覆盖旧记录,而是标记旧记录为“低权重”,新记录为“高权重”;
- 事实类冲突:如“用户说‘住北京’” vs “住上海”,采用“版本化覆盖”,旧记录标记为
superseded(失效),新记录为当前有效版本。
7.2 实现细节
- 带时间戳存储:每条记忆包含
content(内容)、timestamp(时间)、weight(权重); - 检索时加权:权重 = 当前时间 - 记忆时间 × 衰减系数(如 0.9^t,t 为天数),确保新记忆优先被检索。
8. 高频问题速答
Q:多 Agent 如何协作?
A:总控 Agent 识别意图后,动态路由到子 Agent(如“数学题→math_Agent”“写作→writer_Agent”),子 Agent 完成任务后将结果回传给总控,最终整合输出。
Q:群聊场景如何拓展记忆?
A:数据结构增加 Group_ID,每条消息附带 Sender_ID;短期记忆窗口扩大至 20 条,长期记忆按“群组+个人”公私域隔离存储。
Q:如何避免“脏记忆”?
A:记忆写入前需“双重校验”:① 模型对新信息做置信度评估(低置信度进“待确认区”);② 定期审计历史记录,删除重复或矛盾内容。
深度拆解:工程落地的关键挑战
1. 长期记忆增长:如何防止检索变慢?
- 分层治理:高频记忆(如“学习记录”)用向量库实时检索,低频记忆(如“历史对话”)归档至冷存储;
- 聚类压缩:每 100 条相似记忆生成“摘要”,减少向量库条数。
2. 短期记忆摘要粒度:如何避免信息丢失?
- 关键信息分流:用户问题含“身份信息”(如“我叫小明”),直接存入长期记忆;
- 增量摘要:每 5 轮对话生成“增量摘要”(仅新增内容),避免重复计算。
3. 死循环终止:如何确保 Agent 收敛?
- 强制终止条件:设置最大轮次(如 10 轮)或最大 Token 消耗(如 1000 Token);
- 重复检测:连续 3 轮调用同一工具且结果无变化,判定为“幻觉”,触发反思。
小结
Agent 与记忆系统的核心是“记忆管理 + 自主规划”:
- 记忆系统:短期用滑动窗口+摘要,长期用向量库+分类管理,冲突处理靠时间衰减;
- Agent 规划:简单任务用 ReAct,复杂任务用 ToT/GoT,工业级用 Plan-and-Execute + Reflexion;
- 框架选择:线性任务用 LangChain,复杂循环/多 Agent 用 LangGraph,需自主决策场景优先 Agent。
掌握这些技术,你就能构建稳定、高效的 AI 应用“大脑”,处理从简单问答到复杂任务的全场景需求。
评论